2026年10月8日から9日にかけて、ラトビア共和国の首都リガにて開催されている Zabbix Summit 2026 に参加しております。
本記事では、2日間開催されるイベントの、2日目の様子をレポートいたします。
はじめに
Zabbix Summit 2026 レポートの2日目では、大規模な監視環境を支える技術的な工夫から、収集したデータの活用、ビジネスサービスの信頼性管理まで、幅広いテーマの講演をいくつかピックアップして紹介します。
今回取り上げる講演では、毎秒 100 万件の新規監視値を扱うための性能面の工夫や、日々の運用を効率化する機能、製造現場の業務アプリケーションを支える監視事例が紹介されました。さらに、Zabbix が収集したデータをレポートや AI による異常検知に活用する方法や、サービス全体の状態を可視化して SLA の管理につなげる取り組みも取り上げられました。
これらの講演に共通しているのは、監視データを収集して異常を通知するだけでなく、その情報を運用の改善や業務上の判断に役立てようとしている点です。それぞれの講演から、Zabbix の機能をどのように活用し、監視の効率化やサービスの安定運用につなげているのかを見ていきます。
大規模監視と日々の運用を支える Zabbix の工夫
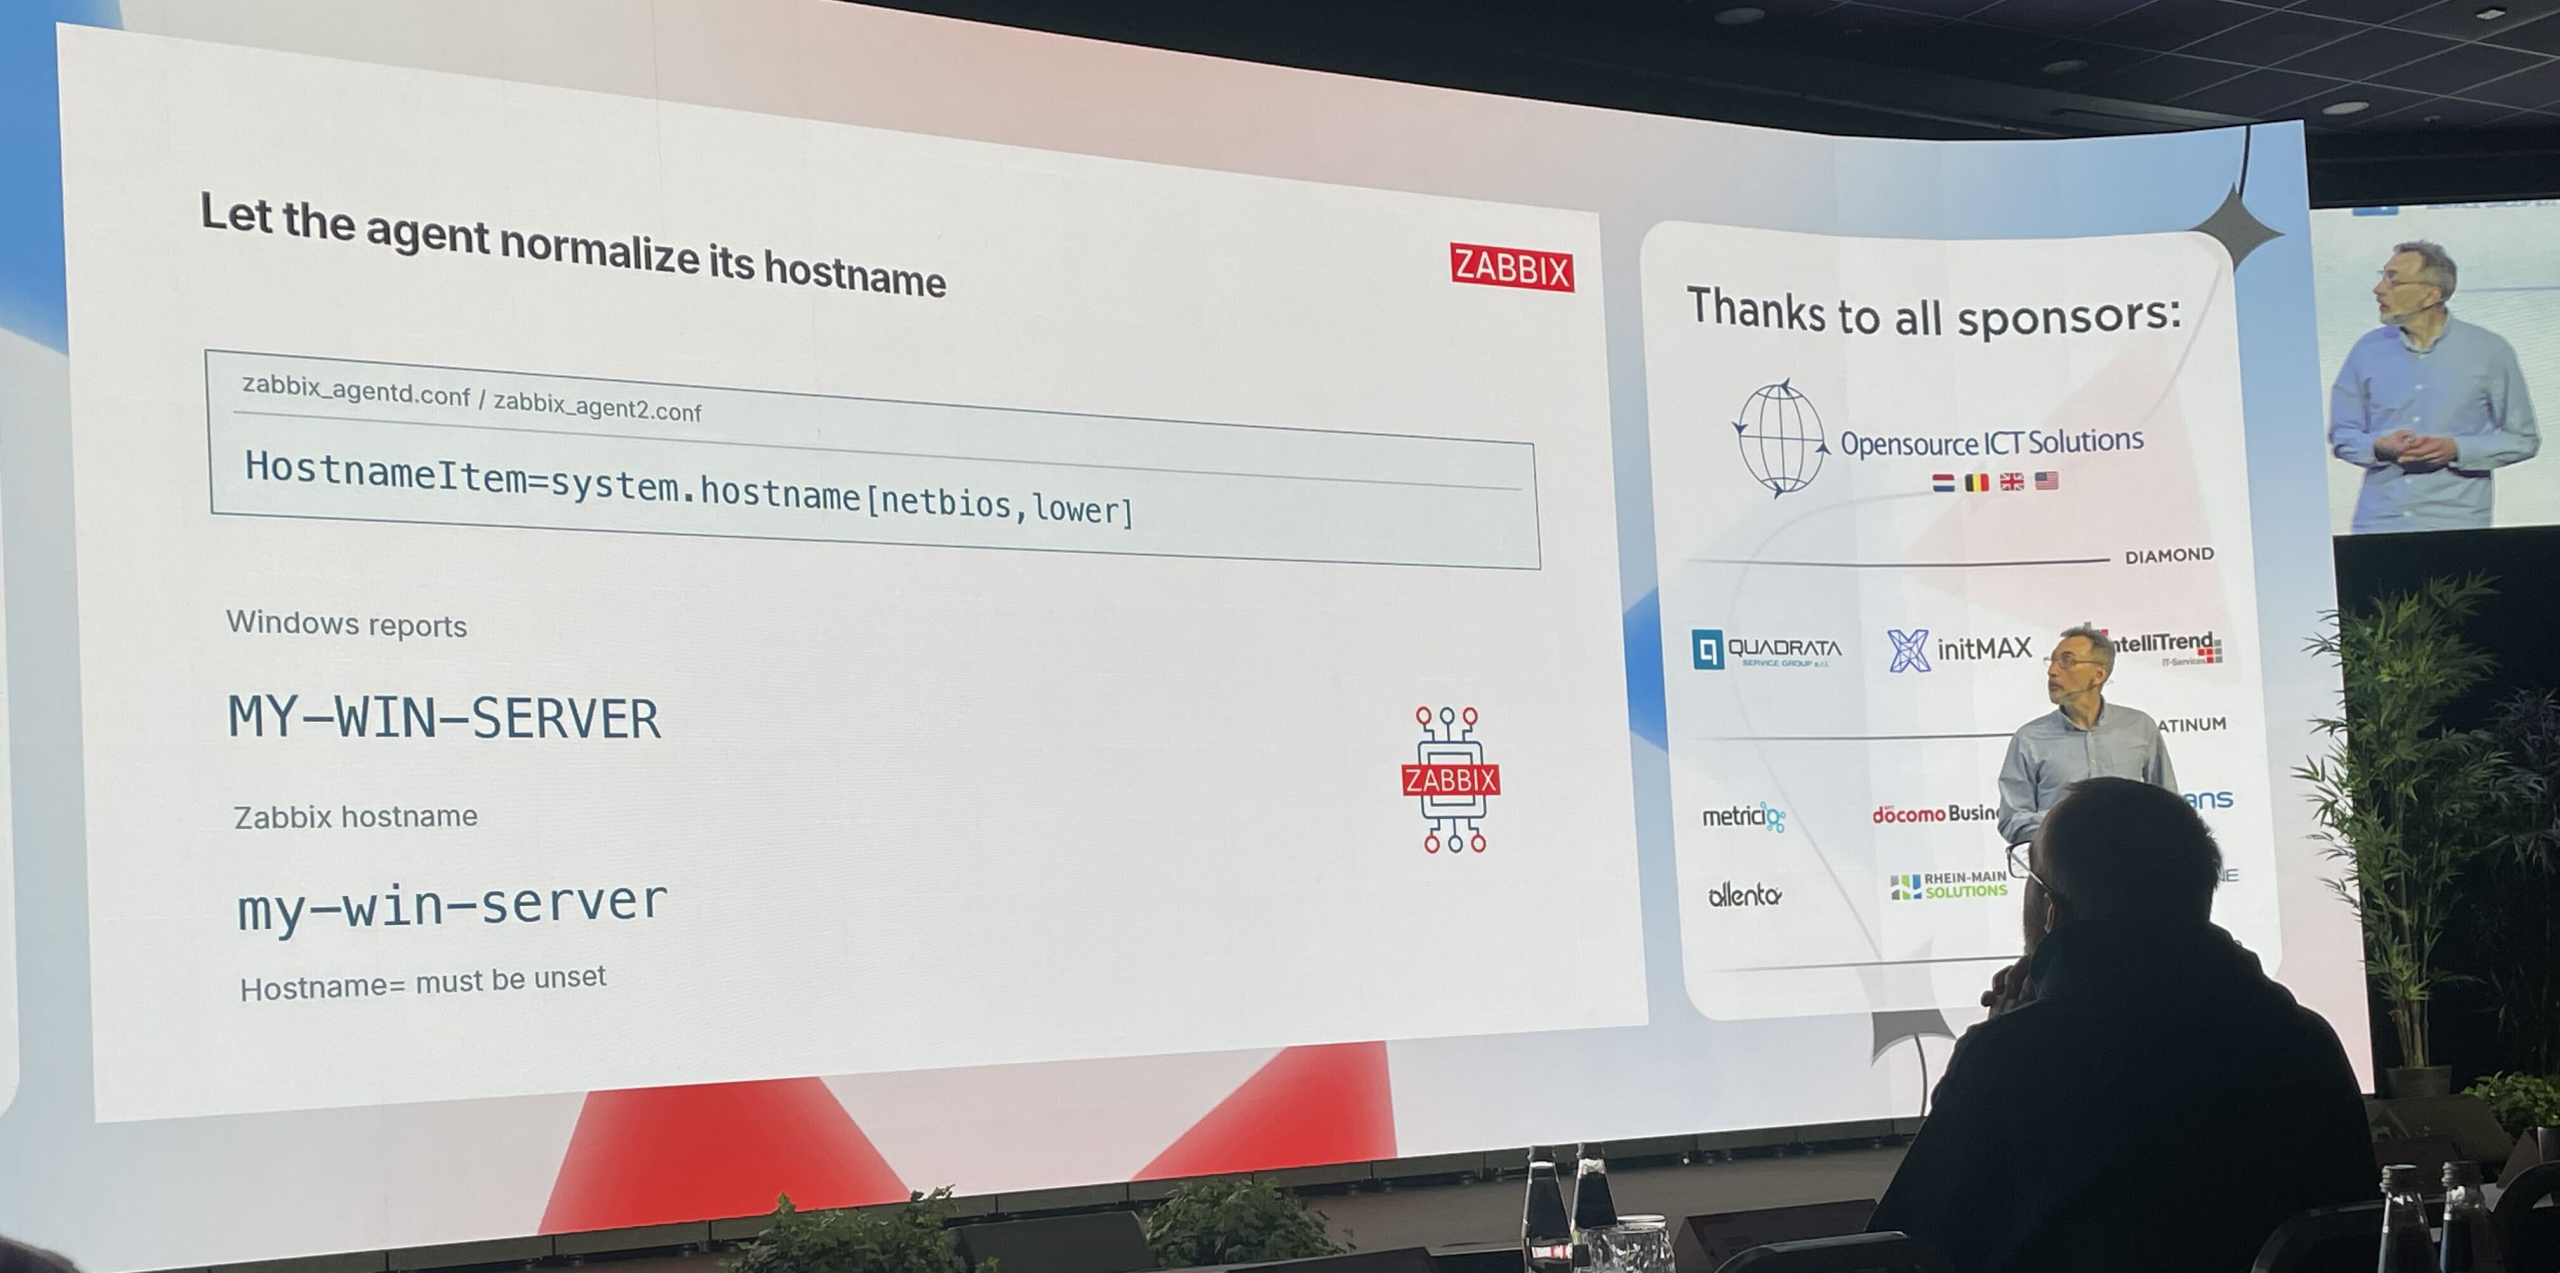
Aleksandrs Kalimulins 氏の講演「Achieving 1M NVPS and Other Little Things」では、毎秒 100 万件の新規監視値を扱うというテーマとともに、日常の運用に役立つ Zabbix の機能が紹介されました。エージェント設定の簡素化からプロキシの運用、マクロによる通知の改善、ブラウザー監視まで、規模の拡大と使いやすさを両立するための工夫が幅広く取り上げられました。
■ エージェントの設定を整理する
エージェントの設定では、ホスト名の取得方法や、長いアイテムキーとパラメータの扱いが話題になりました。環境ごとに異なる情報をどこで設定するかを整理することで、テンプレートの再利用と保守をしやすくできます。短い別名やユーザーパラメータの活用は、複雑な設定を扱いやすくするための手段として紹介されました。
また、単一のエージェントを複数の論理的なホストとして利用する考え方も示されました。アクティブ監視では複数のホスト名を設定する方法があり、パッシブ監視では複数のホストから同じエージェントの接続先を参照できます。同じマシン上の監視対象を分けて管理したい場合に役立ちます。ただし、監視対象をどう分けるかは、テンプレートやパラメータの管理方針と合わせて考える必要があります。
導入を支援する機能として、ホストウィザードも紹介されました。画面の案内に従って設定を進め、生成されたコマンドを実行することで、エージェントの導入を進められます。設定に不慣れな担当者でも、必要な作業を段階的に確認できることが利点です。
■ 分散監視を支えるプロキシ
プロキシについては、収集データの保存方法として、ディスク、メモリ、ハイブリッドという選択肢が説明されました。メモリを使う方式は、収集データのバッファリングに伴うデータベースへの書き込みを抑えられます。ハイブリッド方式はメモリとデータベースを組み合わせるもので、通信状況やデータ保持の要件に応じた使い分けが重要です。軽量な SQLite は、遠隔拠点での運用やデータベースの再作成の容易さという観点から取り上げられました。設定の同期頻度についても、回線帯域や接続の安定性を考慮して調整できます。必要なタイミングで手動の設定更新を行う方法も紹介され、拠点ごとの事情に合わせた運用が示されました。
さらに、対応する範囲で異なるバージョンのプロキシを利用し、サーバーとプロキシを段階的に更新する考え方が説明されました。大規模環境では、すべての拠点を一斉に更新する負担を減らせます。プロキシ側でシークレットマクロを解決する機能も取り上げられ、拠点や役割に応じた秘密情報の取り扱いが話題になりました。
■ トリガーと通知を理解しやすくする
複雑なトリガー式は、設定を読むだけでは判定の理由を把握しにくい場合があります。講演では、マクロや式の構成要素を実際の値に展開して確認し、条件を読み解くための機能が紹介されました。複数のテンプレートや条件を組み合わせた監視では、こうした確認機能が調査を助けます。
通知の内容を充実させる方法として、値や時刻を示すマクロ、式マクロ、文字列変換などのマクロ関数も説明されました。例えば、ディスク容量の問題を知らせる際、対象のファイルシステムや残り容量をメッセージに含めれば、通知を受けた時点で状況を把握しやすくなります。異常の発生だけでなく、対応に必要な情報まで伝えることがポイントです。
■ ウェブ監視と表示機能の活用
ウェブシナリオでは、応答から JSONPath や XPath で値を抽出し、後続のステップで利用する方法が紹介されました。複数のリクエストをつなぐ REST API のテストなどに活用できます。ブラウザーアイテムについては、ログイン操作だけに用途を限定せず、自動操作の仕組みをさまざまな確認に応用する考え方が示されました。Appium を利用したモバイルアプリケーションのテストや、スクリーンショットの取得も話題になりました。一方、ブラウザーポーラーは同期的に処理するため、各チェックの所要時間、実行数、タイムアウトを考慮する必要があります。操作を自動化するだけでなく、監視を継続できる処理能力を見積もることが大切です。
このほか、ダッシュボードの操作性、アイテム履歴ウィジェット、ホストやテンプレートを探すグローバル検索も紹介されました。HTTP エージェントを使った Prometheus エクスポーターからのデータ取得にも触れられ、既存の監視資産を取り込む方法が示されました。
■ 毎秒 100 万件をテーマとした性能検証
講演の終盤では、ClickHouse と連携した構成での性能検証が紹介されました。履歴同期処理やバッファー、保存先の設定を調整し、書き込み先に過剰な負荷をかけないようにする工夫が説明されました。強調されたのは、瞬間的なピークではなく、単一の Zabbix サーバーノードで継続して処理できる負荷として評価する姿勢です。実測値は安定して 毎秒 100 万件処理を続けられることが説明されました。今回の講演は、大規模な処理性能と、日常の小さな運用改善を結び付ける内容でした。データ収集、保存、通知、画面操作をそれぞれ見直すことで、扱いやすく拡張しやすい監視環境につながると実感しました。
Zabbix の監視データを活用する ― AI による異常検知と高度なレポート機能
Wolfgang Alper 氏の講演「Putting Zabbix Data to Work: AI-Based Anomaly Detection and Advanced Reporting」では、Zabbix が収集している大量の監視データを、単なる監視結果として見るだけでなく、Reporting、外部連携、AI-Based Anomaly Detection に活用する方法が紹介されました。Alper 氏は、Zabbix はデータ収集に非常に強い一方で、収集した情報をそのまま監視画面の中だけで使うのではなく、Business Insight に変換することが重要だと説明しました。
■ レポート作成と外部システム連携によるデータ活用
まず紹介されたのが、Widget ベースの Reporting Engine です。考え方は Zabbix ダッシュボードに近く、レポートを複数の Widget の組み合わせとして構成します。Availability、Problem History、Current Problem、Long Running Problem、Graph、Markdown など、用途ごとに異なる Widget を利用でき、Management 向けレポートに必要な背景説明や補足情報も追加できます。レポートの元データは Zabbix API から取得し、Trend だけでなく Alert、Problem、Audit Log など幅広い情報を利用します。
収集したデータは Render Process を通して、人が読むレポートに変換することも、外部システムが再利用できるデータに変換することもできます。人向けには PDF レポートを生成でき、Header、Logo、Title、Table of Contents、Page Number などを含む形式で出力されます。各 Widget は Card のように レポート内へ配置され、Service Availability、MTTR、Problem State、Host Graph などを視覚的に確認できます。一方、システム連携向けには JSON、XML、CSV 形式でのエクスポートに対応し、BI Tool、Spreadsheet、Database、External Dashboard、Message Bus などにデータを渡せます。
講演では、既存データから新しい KPI を作る例として、Mean Time to Interaction や Mean Time to Recovery が紹介されました。Zabbix Event API に既に存在する情報を使って、Tech Support Team が Incident に対応するまでの平均時間や、Incident が Close されるまでの時間を算出できます。つまり、新しいデータを収集しなくても、既存の監視データから Management に有用な指標を作れるという点が重要です。
また、外部システムごとに必要なデータフォーマットが異なる場合に備えて、Transformation レイヤも用意されています。JavaScript の transform Function を使い、Report Object に対してフィールドの追加、削除、値の変更、新しい KPI の生成、Flatten 処理、Schema の変更などを実行できます。例えば外部システムが Report ID を必要とする場合は新しい フィールドを追加し、SLI と SLA の条件を比較して Boolean 値を生成することもできます。さらに、レポートデータを OpenTelemetry Collector が扱える形式に変換する例も紹介されました。
こうした仕組みにより、Zabbix で収集したデータを他部門や別アプリケーションに連携し、監視システムを企業全体のデータソースとして活用できます。特に大規模組織では、監視データを Kafka などの Message Bus に流し、別 Department や Business Application が Subscriber として利用する構成も考えられます。
■ 外部 AI Model による異常検知
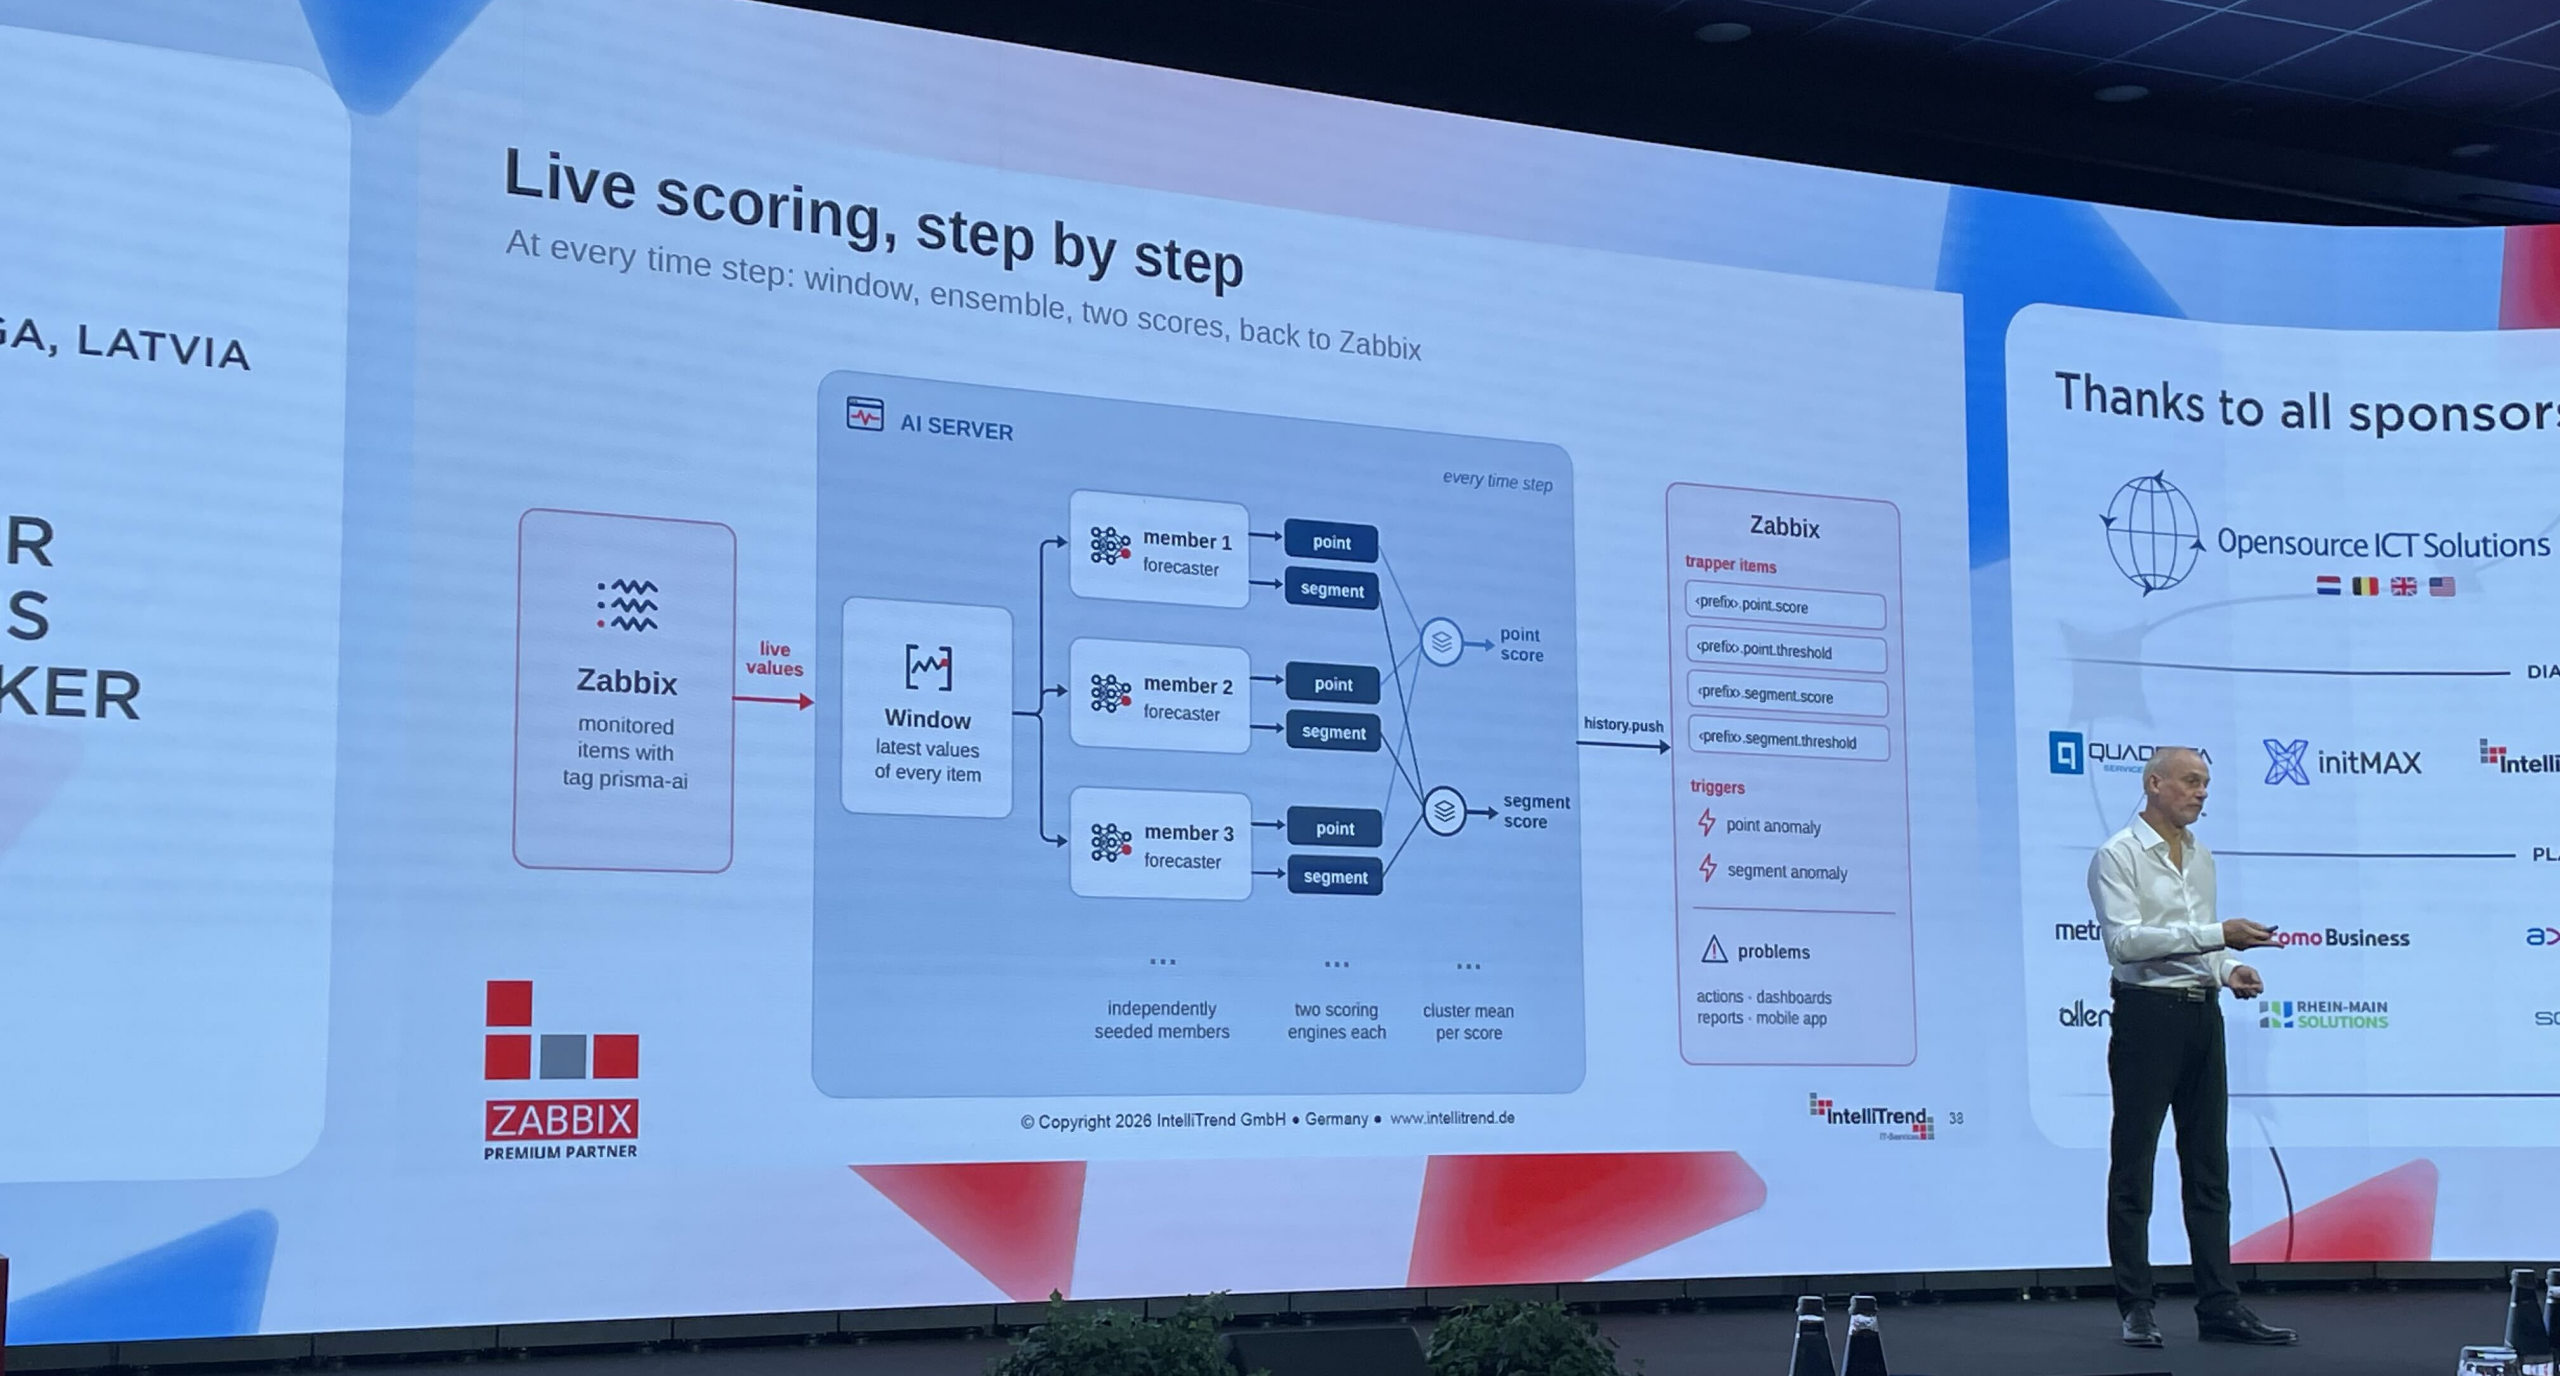
講演後半では AI-Based Anomaly Detection も紹介されました。考え方は、Zabbix から取得した Time Series Data を外部 AI Model に入力し、各 Value が通常の Behavior からどの程度外れているかを Score として返すものです。複数の Model を同時に利用する Ensemble 構成も可能で、例えば 5 個の Model のうち 3 個以上が Anomaly と判断した場合に、最終的に異常として扱うような Majority Vote も設定できます。利用する Model 数を増やせば判定の信頼性を高められますが、その分 AI Server の Resource も必要になります。
AI 側からは Anomaly Score や Segment Score、さらに Trigger 作成の参考になる Threshold などが Zabbix に返されます。これらの値は通常の Zabbix Item と同様に ダッシュボードで確認でき、Trigger Expression に利用できます。つまり、Zabbix 本体の Source Code を変更せず、既存の アイテム、トリガー、ダッシュボードの仕組みを活用しながら、外部 AI Model による Anomaly Detection を組み込める点が特徴です。
■ 収集したデータを新たな価値につなげる
講演の Takeaway として強調されたのは、「もっとデータを集めること」よりも「すでに集めているデータをもっと賢く使うこと」です。監視システムには Infrastructure、Application、Business Activity など大量の情報が蓄積されています。それらは単なる監視用データではなく、企業にとって価値のある Asset です。
Zabbix が収集したデータをレポートに変換し、Management が理解しやすい KPI として提示し、JSON、XML、CSV などで外部システムに渡し、必要に応じて AI Model で Anomaly Detection を行うことで、Monitoring の役割を大きく拡張できます。今回の講演は、Zabbix を「異常を通知する Tool」だけでなく、「企業データを集約し、加工し、外部へ活用するプラットフォーム」として捉える実践的な事例でした。
Zabbix のサービス監視を活用した BSM と SLA 管理
Marek Panečný 氏の講演「Improving Service Reliability With Zabbix SLA Monitoring」では、Zabbix の Service Monitoring 機能を Business Service Monitoring、いわゆる BSM の考え方で活用し、単なる障害監視からサービス全体の信頼性管理へ発展させる方法が紹介されました。Panečný 氏は Asseco CEIT で監視基盤を担当しており、長年さまざまな監視製品を扱ってきた中で、2013 年頃から Zabbix を主要な監視ソリューションとして利用していると説明しました。
■ サービス全体の状態を可視化する BSM と SLA 監視
一般的な IT 環境は、Hardware、Operating System、Network、Database など複数のレイヤで構成されています。従来の監視では、それぞれのレイヤに対して Item や Trigger を大量に設定し、「何も気付かないまま壊れる」ことを避けるようにします。この方法自体は正しいものの、監視対象が増えるほど Problem や Notification も増え、いわゆる Alert Flood が発生しやすくなります。また、個々の Component の状態は分かっても、「その障害が Business Service にどの程度影響しているか」までは分かりにくいという課題があります。
そこで BSM では、通常の監視レイヤの上に Business レイヤを追加します。その中心となるのが Service Tree です。Service Tree は、Service や Service Component を Node として表し、それらの関係性を Tree 構造として定義するものです。各 Node には Severity や Status があり、下位 Node の状態を上位 Node に伝播させることで、サービス全体への影響を可視化できます。また、この Service Tree があることで、SLA Report、Impact Analysis、Root Cause Analysis といった処理の基盤を作ることができます。
Zabbix は標準機能として、Service Tree の構築、Problem と Service Node の関連付け、伝播や相関のルール、さらに各 Service に対する SLA 設定を提供しています。Problem と Service Node の紐付けには Tag を利用できるため、特定の Problem Severity や条件を Service の状態へ反映できます。そのため、Business Service Monitoring の基本機能は標準の Zabbix だけでも構築可能です。
■ 独自の Widget と Module によるサービス監視の強化
一方で、講演では標準機能の弱点も指摘されました。最も大きな課題は Service Tree の表示方法です。Zabbix 標準では Service Tree を本当の Tree 形式ではなく Table 形式で表示するため、構造が複雑になるほど関係性を直感的に把握しづらくなります。また、Service Tree をダッシュボード上に表示する専用 Widget がなく、Service Tree 自体の自動生成機能もありません。そのため、大規模環境では構築や保守を手作業で行う必要があります。
この課題を補うため、Asseco CEIT では 2 つの Widget と 1 つの Module を独自に開発しました。
- Service Tree Widget
これは Service Tree を実際の Tree 構造としてダッシュボード上に表示します。Node に Mouse Pointer を合わせると詳細情報を表示でき、対象 Service の Status や Severity が時間とともにどのように変化したかも確認できます。 - Service History Report Widget
これは複数の Service Node の状態変化を時間軸で表示し、Downtime の割合や継続時間、最終状態変更時刻などを確認できます。Service の信頼性を履歴として把握できるため、SLA の評価や障害傾向の確認にも役立ちます。 - Impact Analysis Module
これは Problem 一覧から特定の Problem を選択した際に、その Problem が Service Tree のどの Node に影響しているかを表示します。Problem から直接 Impact Analysis を開始できるため、単に「障害が発生した」という情報だけでなく、「どの Business Service に、どの範囲で影響しているか」を素早く把握できます。
これらの拡張機能を標準の Zabbix Service Monitoring と組み合わせることで、CIO、Service Owner、Manager など、技術詳細より Business Impact を重視する利用者にも分かりやすい Monitoring が可能になります。Service Tree を視覚的に確認し、Node ごとの履歴や SLA を把握し、Problem から Impact Analysis を行い、さらに Service Node の状態変化を Alert の起点として利用することもできます。
■ SLA 監視をサービスの信頼性向上につなげる
今回の講演のポイントは、Zabbix の Service Monitoring 機能は単なる補助機能ではなく、Business Service Monitoring を実現するための重要な基盤になり得るという点です。一方で、Service Tree の Visualization や自動生成にはまだ改善の余地があり、今後は Automatic Discovery や Service Tree の自動構築機能が加わることで、さらに実用性が高まることが期待されています。
ラリーカー製造を支える Teamcenter 監視―― PLM を止めないための実践
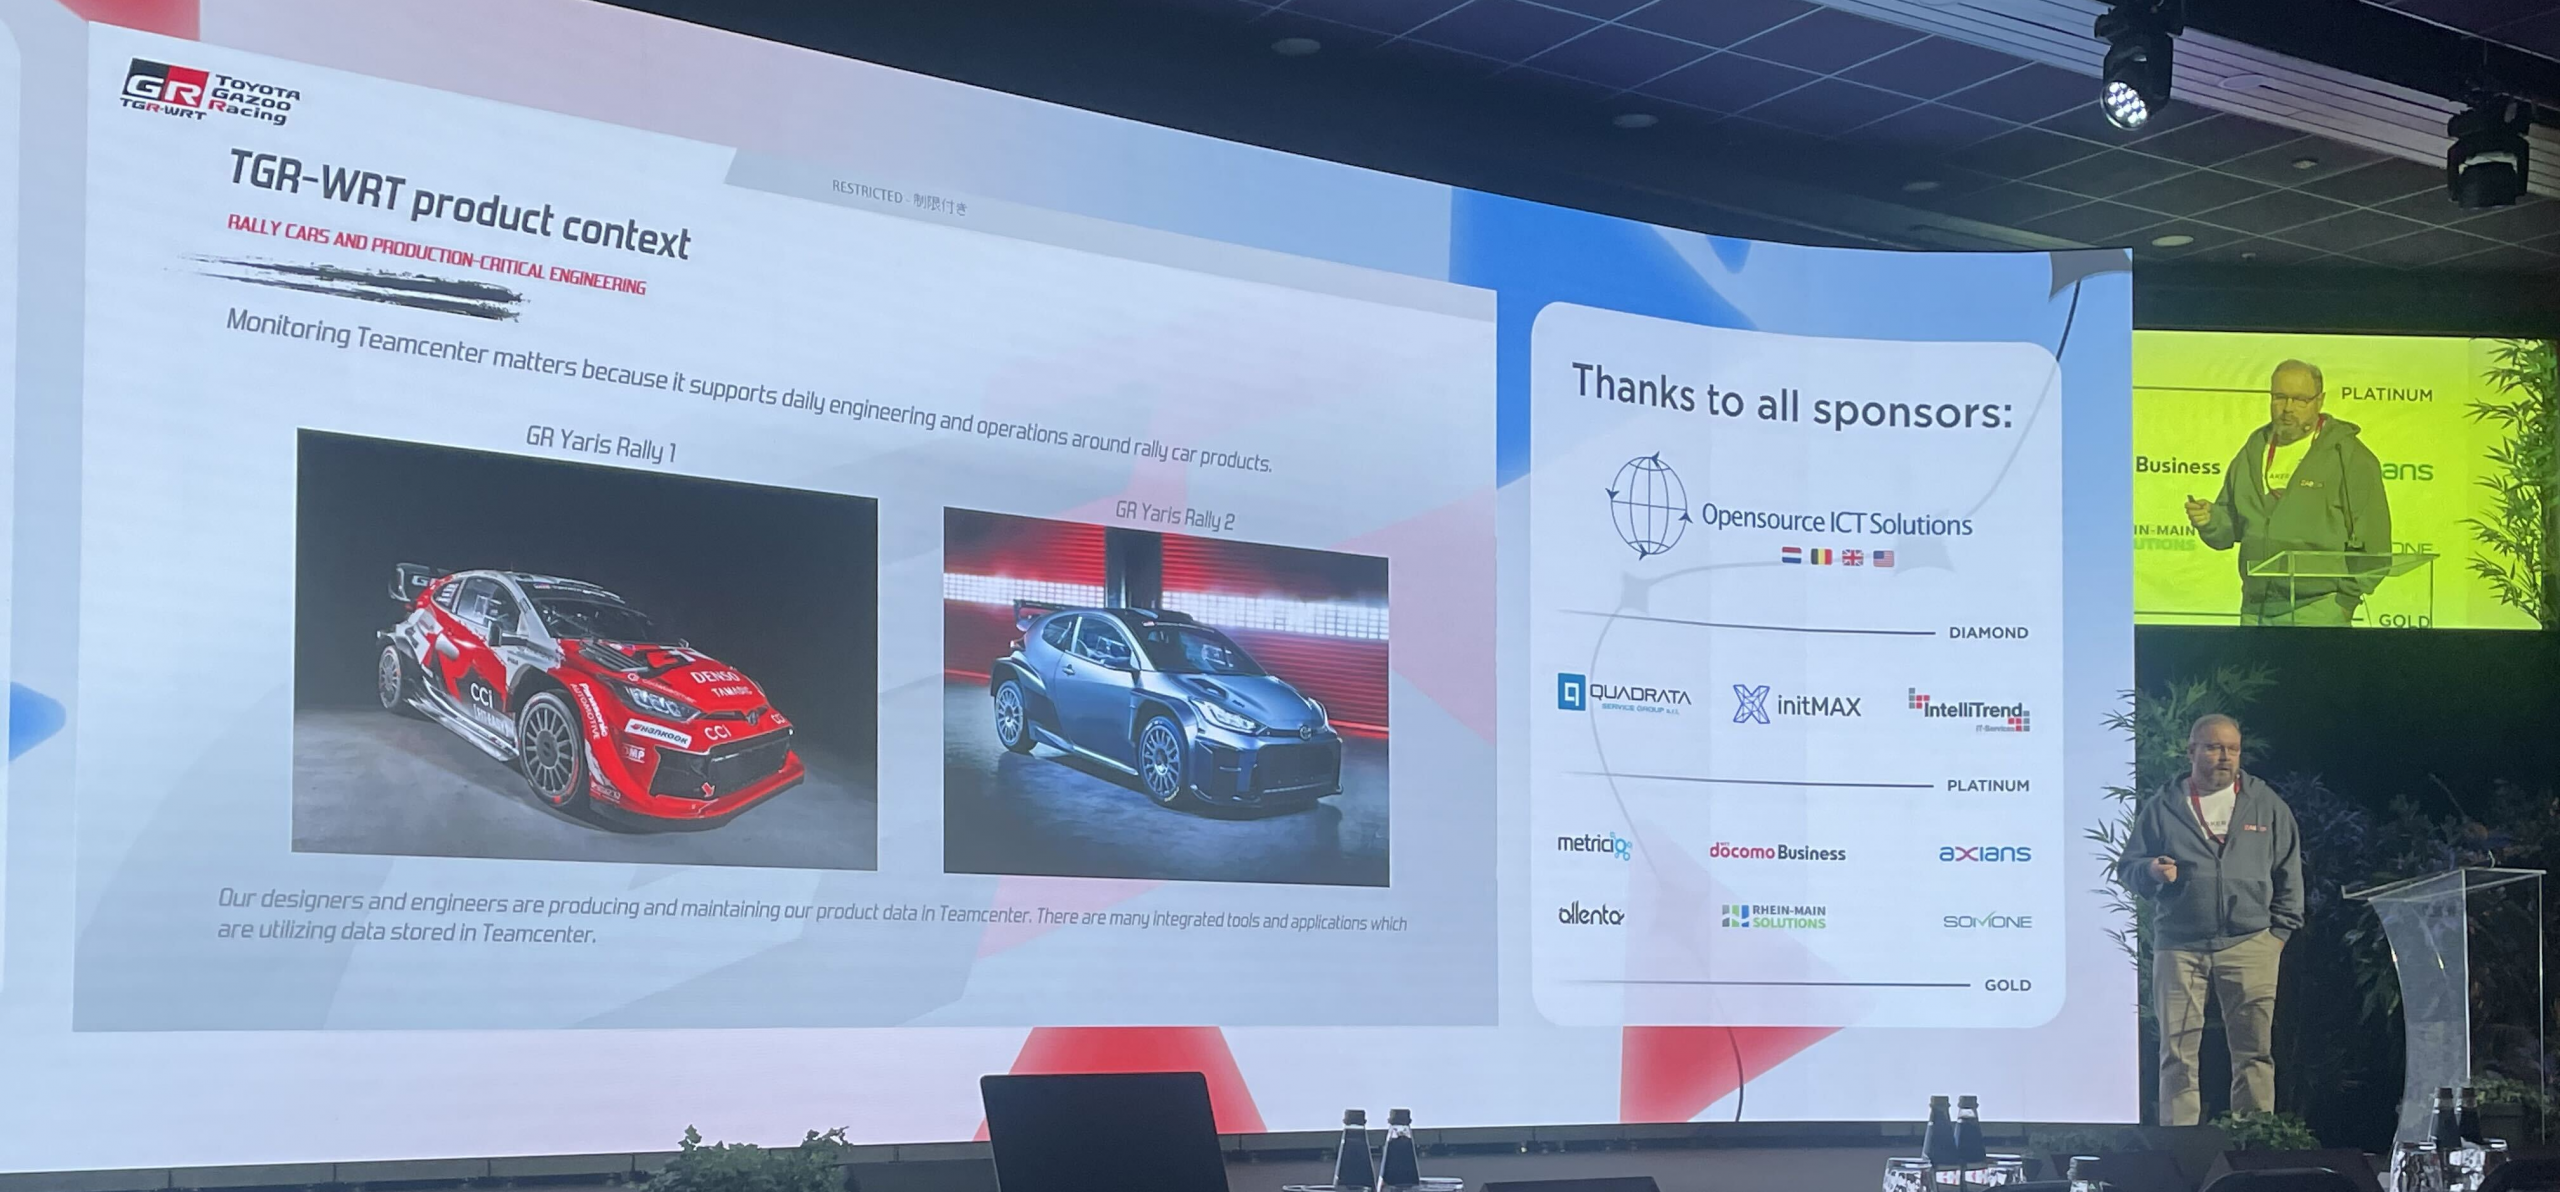
Marko Väätänen 氏の講演「Keeping PLM at Full Throttle: Teamcenter Monitoring in Rally Cars Manufacturing」では、ラリーカー製造で利用する Teamcenter を対象に、Zabbix による監視の実践が紹介されました。中心となるテーマは、サーバーの稼働状況だけでなく、アプリケーションや業務の流れまで把握し、製造を支える PLM(製品ライフサイクル管理)環境の安定運用につなげることです。講演では、本番環境のダッシュボードや通知の例を交えながら、現場で必要とされる監視の考え方が説明されました。
■ 正常な状態を定義し、監視の範囲を広げる
監視を設計する出発点は、何をもって正常と判断するのかを定義することです。Teamcenter が正常に機能しているかを判断するには、その基盤となるサーバーやデータベースに加え、関連するサービスや自動化処理にも目を向ける必要があります。講演では、一般的な基盤監視と Teamcenter 固有の監視項目を組み合わせ、必要な情報を収集する構成が紹介されました。
具体的な対象として挙げられたのは、データベースの状態、アプリケーションのプロセスごとのメモリ消費量、ファイルの欠落、Windows イベントログなどです。メモリリークの検出も監視対象に含まれており、サービスが起動しているかどうかだけでは分からない問題を捉えようとしています。メモリ使用量をグラフで確認することで、ある時点の値だけでなく、時間の経過に伴う変化を追える点も紹介されました。
■ 業務のワークフローに踏み込む
この事例で注目したいのは、Teamcenter 固有のワークフローを監視対象としている点です。基盤側の状態を確認するだけでなく、アプリケーション内部の処理が期待どおりに進んでいるかを追跡する視点が示されました。処理の連鎖の中に問題があっても、監視がなければ担当者が気付けない場合があるという説明は、業務に近い層を可視化する重要性を表しています。
一方で、ワークフローから必要な情報を取り出す作業は、簡単ではないことも語られました。どの情報を取得したいのか、どの条件で結果を抽出するのかを明確にし、Teamcenter のデータベースや処理の構造に合わせて設定する必要があります。
講演では、UserParameter を使った情報取得や、特定のイベントに対応するトリガーの設定にも触れられました。監視項目を増やすだけでなく、業務上の問題を判断できる情報に整えることが、実装上の要点として読み取れます。
■ ダッシュボードで利用状況をまとめて確認する
本番環境の監視画面では、サービスの状態とともに、ユーザー数やログインに関する情報を確認する例が示されました。複数の情報を一つの画面にまとめることで、担当者が環境全体の様子を把握しやすくしています。日常的に確認する情報を集約することは、異常が起きた際に、どこを調べるべきか判断する助けにもなります。
ライセンスも重要な可視化対象です。講演では、利用中のライセンス数や期限に関する情報を扱い、ダッシュボードで確認する仕組みが紹介されました。システムの稼働状況に加えて、利用者が実際にサービスを使うための条件まで把握している点が特徴です。監視対象となるユーザーのリストを更新する運用にも触れられ、収集対象を実態に合わせて維持する必要性がうかがえました。
■ 通知を、確認と対応につなげる
異常を迅速に知るためのアラームは欠かせませんが、通知が多くなると、その内容を確認して対応すること自体が課題になります。講演でも、多数のメール通知を受け取る状況が取り上げられました。情報を集めて通知する仕組みを整えるだけでは、運用上の負担がなくなるわけではありません。
そこで言及されたのが、事前チェックやワークフローの状態確認です。自動化を考える際にも、対象の状態を確かめる仕組みが必要であり、通知から直ちに処理を実行すればよいという単純な話ではありません。また、チームからの連絡や確認を取り入れるフィードバックの流れも紹介されました。監視で得た情報と現場で把握した状況を照らし合わせることが、問題の確認や対応を支えています。
■ 製造を支えるアプリケーション監視の価値
今回の講演が示したのは、監視対象をインフラからアプリケーション、さらに業務の流れへと広げる実践です。データベース、プロセス、ログ、ファイル、ライセンス、ワークフローをそれぞれ確認することで、単一の指標では見えない問題を捉えようとしています。その実現には、Teamcenter の内部構造と運用を理解し、必要な情報を選び取る作業が欠かせません。
ラリーカー製造という現場を支える PLM 環境において、監視は障害を知らせるだけの仕組みではありません。担当者が日々の状態を理解し、見落としやすい問題に気付き、対応へ進むための基盤です。Zabbix の収集・可視化・通知の機能を、対象アプリケーションの特性に合わせて組み合わせることの価値が伝わる事例でした。
おわりに
今回紹介した講演では、大規模なデータ収集を支える性能面の工夫から、日々の運用を効率化する機能、アプリケーションや業務サービスの状態を把握するための監視、さらには AI や外部システムとの連携まで、Zabbix の幅広い活用方法が紹介されました。
毎秒 100 万件の新規監視値を扱うための性能検証では、データの収集や保存の仕組みを適切に調整することの重要性が示されました。また、エージェントやプロキシの設定、通知メッセージの改善といった日々の運用に関わる工夫も取り上げられ、監視環境の規模を拡大することと、扱いやすさを両立するための考え方を知ることができました。
一方、Teamcenter の監視事例や SLA 監視の講演では、インフラの稼働状況だけでなく、アプリケーション内部の処理や業務サービスへの影響まで把握することの重要性が示されました。さらに、収集したデータをレポートや KPI に変換し、外部システムや AI による異常検知に活用する取り組みからは、監視データを運用改善や意思決定に役立てる可能性が見えてきます。
これらの事例から、監視環境を改善するうえでは、単に監視項目を増やしたり、より多くのデータを収集したりするだけでなく、何を把握したいのか、得られた情報を誰がどのように活用するのかを考えることが重要だと感じました。
Zabbix には、データ収集、障害検知、可視化、通知、サービス監視など、さまざまな機能が備わっています。これらを監視対象や運用上の課題に合わせて組み合わせることで、障害の早期発見にとどまらず、日々の運用の効率化やサービスの信頼性向上にもつなげることができます。
Zabbix Summit 2026 で紹介された事例や考え方を参考に、私たちもお客様の環境や課題に応じた監視のあり方を考え、より実用的な監視・運用の実現に取り組んでいきたいと思います。